Tema
Instruções e Modelo
Pensa assim: as instruções do Agent são o "manual de treinamento" do seu atendente virtual. Quanto mais claro e detalhado for esse manual, melhor ele vai se comportar. O modelo de IA (também chamado de LLM — o tipo de inteligência artificial que entende e gera texto) é o "cérebro" que vai executar essas instruções — e escolher o cérebro certo faz diferença no custo e na qualidade das respostas.
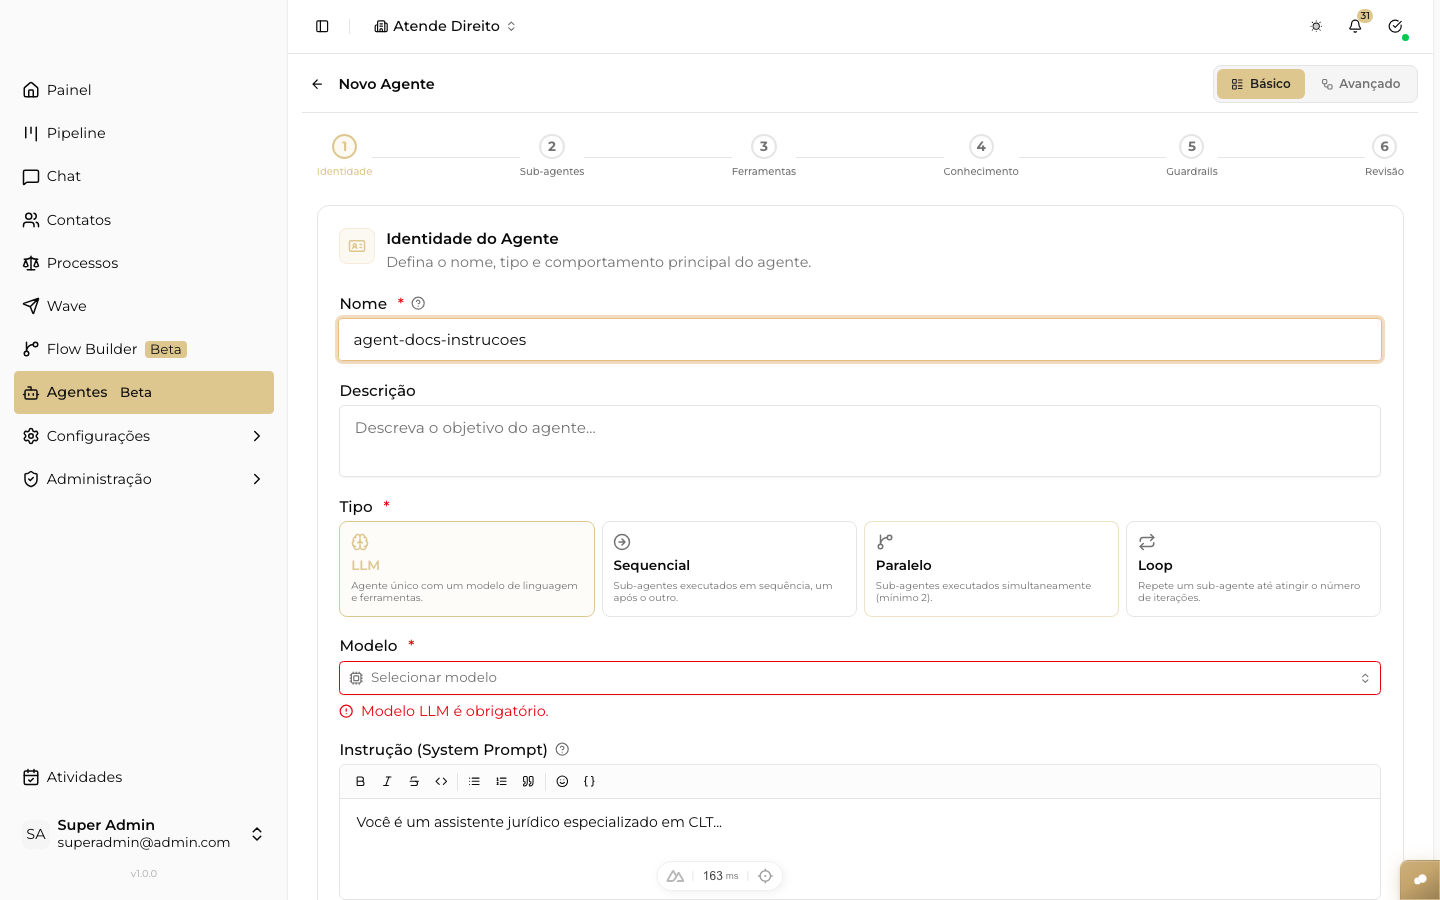
Campo Instrução (System Prompt) do Agent, na aba Identidade, com a barra de formatação e o texto da instrução.
Tipos de Agent
Antes de configurar, escolha o tipo certo para o seu caso de uso:
| Tipo | Quando usar |
|---|---|
| LLM | Conversas simples com um único modelo. Ideal para começar. |
| Sequencial | Tarefas com etapas definidas em sequência (ex.: coletar dados → validar → responder). |
| Paralelo | Quando você quer consultar várias fontes ao mesmo tempo (mais rápido). |
| Loop | Quando o Agent precisa repetir um ciclo até atingir um resultado (ex.: refinar uma resposta). |
Campo: Instruções
As instruções são o texto que define a personalidade, o escopo e as regras de comportamento do Agent — o que na área de IA às vezes é chamado de "system prompt".
Boas práticas para escrever instruções:
- Comece com identidade: "Você é um assistente de atendimento da empresa X."
- Defina o tom: "Responda de forma educada, direta e em português."
- Liste o que pode e o que não pode: "Não forneça preços. Não discuta concorrentes."
- Dê exemplos de resposta para casos comuns: o Agent vai aprender o padrão.
- Inclua como lidar com o que não sabe: "Se não souber a resposta, diga 'Não tenho essa informação e vou verificar com nossa equipe'."
Campo Instrução (System Prompt) do Agent preenchido com um exemplo de instrução.
Dica
Escreva as instruções como se estivesse explicando para uma pessoa nova na empresa. Não use siglas internas sem explicá-las — o Agent não conhece o contexto da sua empresa a não ser pelo que você escrever aqui.
Regra de Voz: fale DIRETO ao contato (sem narração interna)
Agents que respondem ao cliente no WhatsApp têm um erro comum: o modelo começa a "apresentar" a resposta como se estivesse entregando uma tarefa, em vez de falar diretamente como o atendente.
Exemplos de respostas erradas que o modelo pode gerar:
"Negócio criado e tag adicionada! Agora vou responder o Lucas. Preciso criar o produto primeiro... Primeiro, a conversa: *Ótimo, Lucas!*…""Perfeito! Aqui está o atendimento: Olá, Lucas! Entendi, você quer saber sobre atraso de viagem."
Por que acontece: o modelo trata as ações internas (como atualizar o CRM) como parte do próprio raciocínio e narra tudo em voz alta, para só depois "entregar" a mensagem ao contato como se fosse um produto pronto.
Como corrigir nas instruções: inclua uma orientação de voz explícita. Exemplo de bloco para adicionar no campo de instruções:
VOZ: você fala DIRETO ao contato no WhatsApp, em 1ª pessoa, como se a mensagem já estivesse na tela dele. A sua saída É a mensagem — sem moldura.
- NUNCA narre ações internas (criar/mover negócio, aplicar tag, associar produto, consultar sistema).
- NUNCA anuncie o que vai fazer ("Agora vou...", "Preciso criar...", "Vou verificar...").
- NUNCA use preâmbulo de entrega ("Perfeito! Aqui está:", "Primeiro, a conversa:", "Aqui está o atendimento:").
- Confirmações ao contato são naturais e sobre o serviço ("Pronto, agendei para...", "Enviei o contrato!"), nunca sobre operações internas de sistema.
Coloque esse bloco antes das regras de negócio, para que o modelo trate a voz como uma restrição de formato, não como detalhe opcional.
Atenção
Agents orquestradores (que apenas roteiam a conversa para outro agent, sem falar com o contato) não devem receber essa regra — eles nunca devem gerar texto para o lead. A regra de voz é exclusiva para agents que efetivamente respondem na conversa.
Condução por etapas sem repetir perguntas
Em uma qualificação longa, escreva a instrução como uma sequência de etapas. Antes de responder, o Agent deve preencher essas etapas com a mensagem atual, o histórico e os fatos conhecidos; depois, faz somente a primeira pergunta ainda pendente.
Inclua estas regras no prompt:
- faça uma pergunta por turno, contando todos os balões da resposta;
- nunca repita a abertura ou uma pergunta já respondida;
- se a resposta vier parcial, pergunte apenas o detalhe ausente;
- a correção feita agora pelo contato prevalece sobre a memória antiga;
- responda a dúvida atual primeiro e depois retome a etapa pendente;
- faça handoff antes de pedir dados ou documentos sensíveis;
- depois do handoff confirmado, o Flow não deve acionar novamente o Agent enquanto a conversa estiver com uma pessoa.
Timers, reengajamento e sequências automáticas pertencem ao FlowBuilder, não ao prompt. Para persistir o que já foi informado entre conversas, habilite a extração na configuração de memória do Agent e também a leitura de memória no nó Agente de IA. Veja Jornada do Lead e Memória do Agent.
Campo: Modelo de Mensagem
O modelo de mensagem (template) define como a entrada do cliente chega até o Agent. Você pode usar variáveis do fluxo para enriquecer essa entrada com contexto.
Exemplo:
Cliente: {{event.contact.name}}
Mensagem: {{userinput.query}}
Histórico de compras: {{vars.purchase_history}}
As variáveis entre {{ }} são preenchidas automaticamente com dados do fluxo no momento em que o Agent é acionado. Isso permite que o Agent já receba contexto do cliente sem precisar perguntar.
Variáveis disponíveis comuns:
| Variável | O que contém |
|---|---|
{{event.contact.name}} | Nome do contato |
{{userinput.query}} | Última mensagem enviada pelo usuário |
{{conversation.id}} | ID da conversa atual |
{{vars.nome_da_variavel}} | Qualquer variável definida no fluxo |
Campo Instrução (System Prompt) do Agent, onde variáveis do fluxo também podem ser referenciadas dentro do texto.
Modelo e Configuração
Aqui você escolhe qual IA vai "pensar" pelas instruções que você escreveu.
Campos de configuração:
| Campo | O que faz |
|---|---|
| Provedor | Quem fornece o modelo: OpenAI, Anthropic, Google, etc. |
| Modelo | O modelo específico: gpt-4o, claude-sonnet-4-5, gemini-pro, etc. |
| Modo | Conversacional (chat) ou geração de um único texto (completion) |
O Agent principal não tem campo de Temperatura nem de tamanho máximo de resposta: ele usa os valores padrão do modelo. A Temperatura e o Top-P existem só na configuração de cada sub-agent.
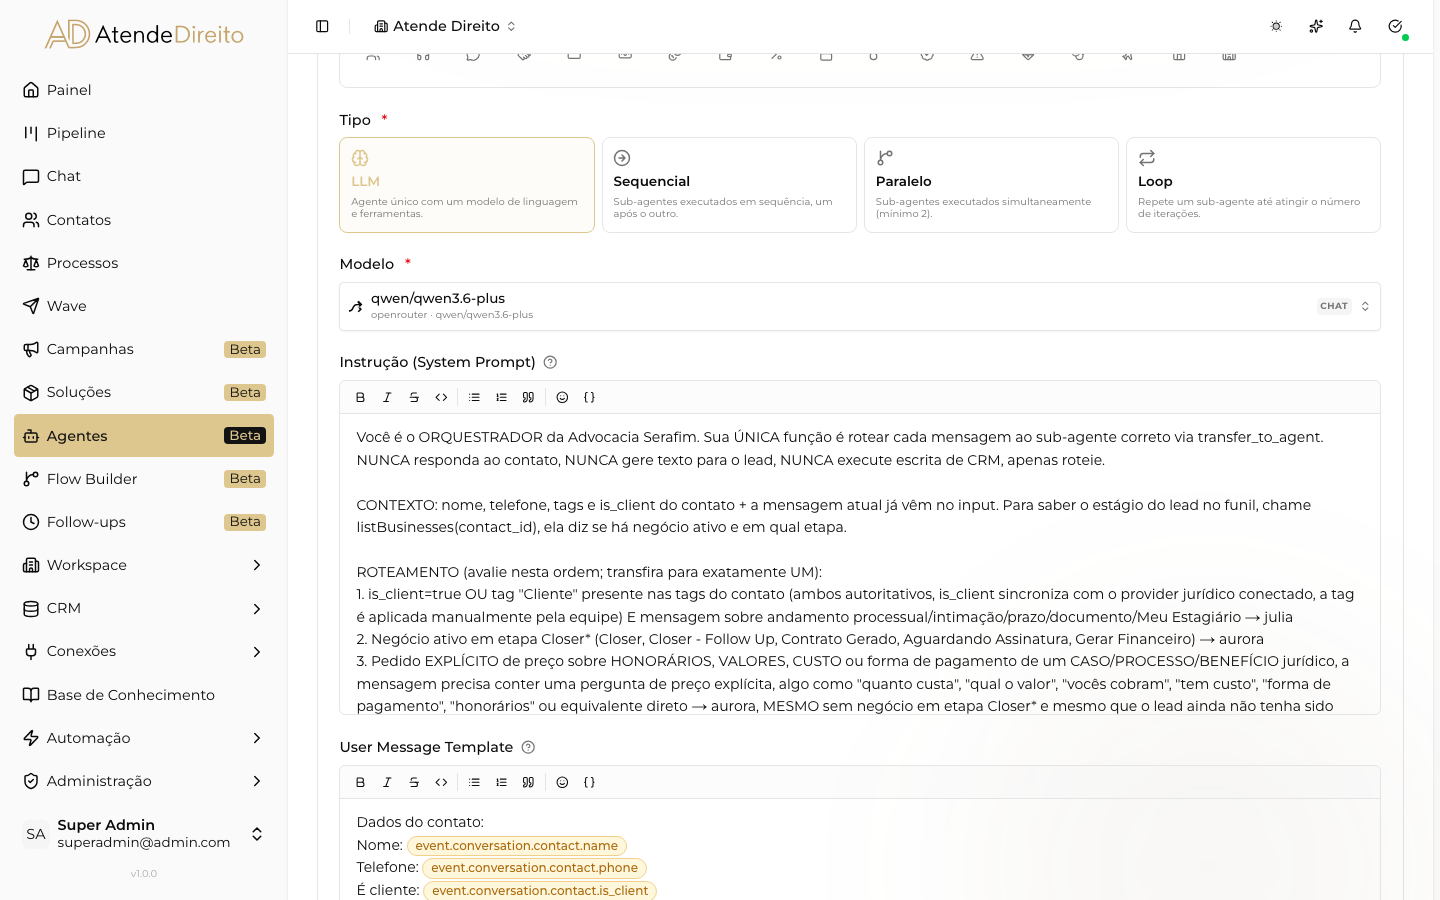
Tipo LLM selecionado logo acima do campo Modelo, seguido da Instrução (System Prompt).
Atenção
Atenção ao escolher entre um modelo nativo e o mesmo modelo via OpenRouter. O catálogo mostra, para vários modelos, duas entradas com o mesmo nome amigável — uma servida diretamente pelo provedor (ex.: OpenAI, Google, xAI) e outra servida via OpenRouter (um serviço intermediário que dá acesso a vários provedores com uma única credencial). Elas usam credenciais diferentes e o comportamento em runtime muda conforme qual você escolhe:
- Se o identificador do modelo não tem
/(ex.:gpt-4o-mini,o1,gemini-2.5-flash) → o Agent usa a credencial nativa do provedor correspondente (OpenAI, Google, xAI etc.), configurada em Conexões. - Se o identificador do modelo tem
/(ex.:openai/gpt-4o-mini,google/gemini-2.5-flash) → o Agent usa a credencial do OpenRouter. - Exceção: a Groq. Os modelos da Groq aparecem no seletor com identificador começando em
groq-(ex.:groq-gpt-oss-120b) e usam a credencial nativa da Groq. O identificador que a API da Groq usa de verdade tem barra (openai/gpt-oss-120b) e é idêntico a um modelo servido também pela OpenRouter — o prefixogroq-existe justamente para você (e a plataforma) conseguir distinguir os dois. A tradução para o identificador real acontece nos bastidores.
O seletor de modelo no Flow Builder mostra o identificador completo (abaixo do nome, na lista e no campo já selecionado) exatamente para deixar isso claro. Se o identificador não tiver a credencial correspondente configurada no workspace, o Agent falha ao tentar chamar o modelo. Confira sempre o identificador — não só o nome — antes de salvar.
Atenção
Modelos Claude: Temperatura e Top P deixaram de ser aceitos. A Anthropic depreciou os dois parâmetros — a chamada volta com erro (temperature is deprecated for this model) e o Agent falha sem responder nada ao contato. Não é preciso fazer nada: a plataforma detecta a recusa, remove os parâmetros e repete a chamada sozinha, e passa a não enviá-los mais para aquele modelo. O contato não percebe nada além de uma primeira resposta um pouco mais lenta.
Isso vale para Claude nativo (identificador sem /, ex.: claude-sonnet-4-5) e para Claude via OpenRouter (anthropic/claude-sonnet-4-5) — a OpenRouter repassa os parâmetros ao provedor sem filtrar, então a recusa é a mesma pelos dois caminhos.
Nos Agents novos, ao escolher um modelo Claude os campos Temperatura e Top P simplesmente não são gravados. Em Agents antigos os valores podem continuar aparecendo no formulário — pode deixá-los ali, eles não são enviados.
Antes dessa depreciação valia uma regra mais branda, ainda ativa nos modelos Claude que aceitam os parâmetros: Temperatura e Top P não podem ir juntos na mesma chamada. Quando os dois estão preenchidos, a plataforma envia só a Temperatura.
Dica de escolha de modelo:
- Para conversas longas e complexas → modelos maiores (
gpt-4o,claude-opus) - Para respostas rápidas e custo menor → modelos menores (
gpt-4o-mini,claude-haiku) - Para análise de imagens → modelos com suporte a visão
Para ver todos os modelos disponíveis no seletor, com contexto e recursos de cada um, veja o Catálogo de Modelos.
Máximo de Iterações (só no tipo Loop)
O campo Máximo de Iterações aparece apenas em Agents do tipo Loop e é obrigatório, de 1 a 50. É ele que define quantas voltas o sub-agent dá, porque hoje o loop sempre roda até esse limite. Os tipos LLM, Sequencial e Paralelo não têm esse campo. Veja Tipos de Agent → Loop.
Atenção
Cada volta é uma chamada inteira ao modelo. Comece com 2 ou 3 e aumente só se o resultado pedir.
Saiba mais
- Memória — fazer o Agent lembrar de conversas anteriores
- Ferramentas do Agent — conectar sistemas externos, skills e sub-agents
- Tipos de Agent e sub-agents — LLM, Sequencial, Paralelo e Loop
- Avaliação de Agents (Eval) — pontuar as respostas do Agent contra um conjunto de testes
- Otimização de instruções (Optimizer) — reescrever a instrução automaticamente com base no Eval